CUDA, il vero fossato di Nvidia
Nvidia deve il suo dominio a CUDA, la piattaforma software che dal 2006 ha trasformato le GPU in uno standard difficile da abbandonare, più che alla qualità dei suoi chip.

CUDA, il vero fossato di Nvidia
Nov 14, 2026 · @Michele Laurelli
Introduzione
Nvidia ha chiuso l’esercizio fiscale 2026 con 215,9 miliardi di dollari di ricavi, di cui 193,7 dal data center, un margine lordo del 71,1% e una capitalizzazione che a metà novembre resta intorno ai 4.400 miliardi nonostante le turbolenze delle ultime settimane. Le stime sulla sua quota del mercato degli acceleratori per l’intelligenza artificiale oscillano fra il 75 e l’80% dei ricavi, a seconda di come si conta il silicio che gli hyperscaler progettano per uso interno.
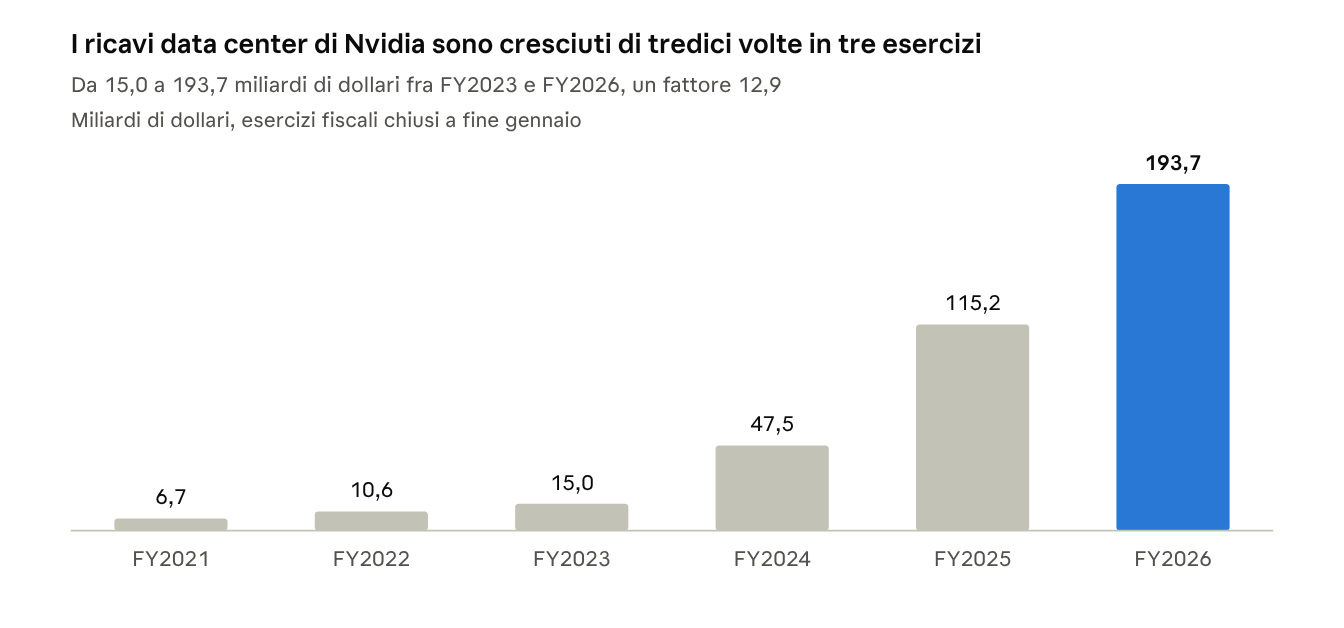
Numeri di questa portata vengono di solito attribuiti alla qualità dei chip, ed è una lettura comprensibile ma incompleta. AMD, Google e una dozzina di startup hanno prodotto per anni silicio competitivo sulla carta senza riuscire a intaccare quella quota, e la spiegazione sta in una piattaforma software che Nvidia ha introdotto nel 2006 e che si chiama CUDA. In vent’anni CUDA è cresciuta da estensione del linguaggio C a ecosistema fatto di compilatori, runtime, oltre mille librerie, strumenti di profilazione, comunità accademiche e abitudini professionali, e la tesi di questo articolo è che il potere di mercato di Nvidia derivi da lì molto più che dai transistor.
Le pagine che seguono spiegano come funziona CUDA sul piano tecnico, come una scommessa a lungo in perdita sia diventata uno standard e quali meccanismi economici l’abbiano resa così difficile da sostituire. L’ultima parte affronta la domanda di queste settimane. Anthropic ha dichiarato agli investitori che il suo modello Mythos ha messo in funzione su GPU AMD l’inferenza di un proprio modello in circa tre giorni invece dei sei-dodici mesi abituali, e lo ha fatto negli stessi giorni in cui Jensen Huang lasciava la guida dell’azienda dopo trentatré anni. Per capire quanto il fossato sia davvero a rischio bisogna distinguere con cura ciò che gli agenti AI rendono facile da ciò che resta difficile, e la conclusione, che anticipo qui, è che CUDA sta perdendo la funzione di barriera prima di perdere quella di standard.
Che cos’è CUDA, dal punto di vista tecnico
CUDA (Compute Unified Device Architecture) è contemporaneamente un modello di programmazione, un insieme di estensioni ai linguaggi C e C++, un compilatore, un runtime, un driver e un’architettura hardware pensata per essere programmata in quel modo. Questa sovrapposizione è il primo elemento da capire, perché è proprio la coerenza fra i livelli a rendere CUDA qualcosa di più di una API.
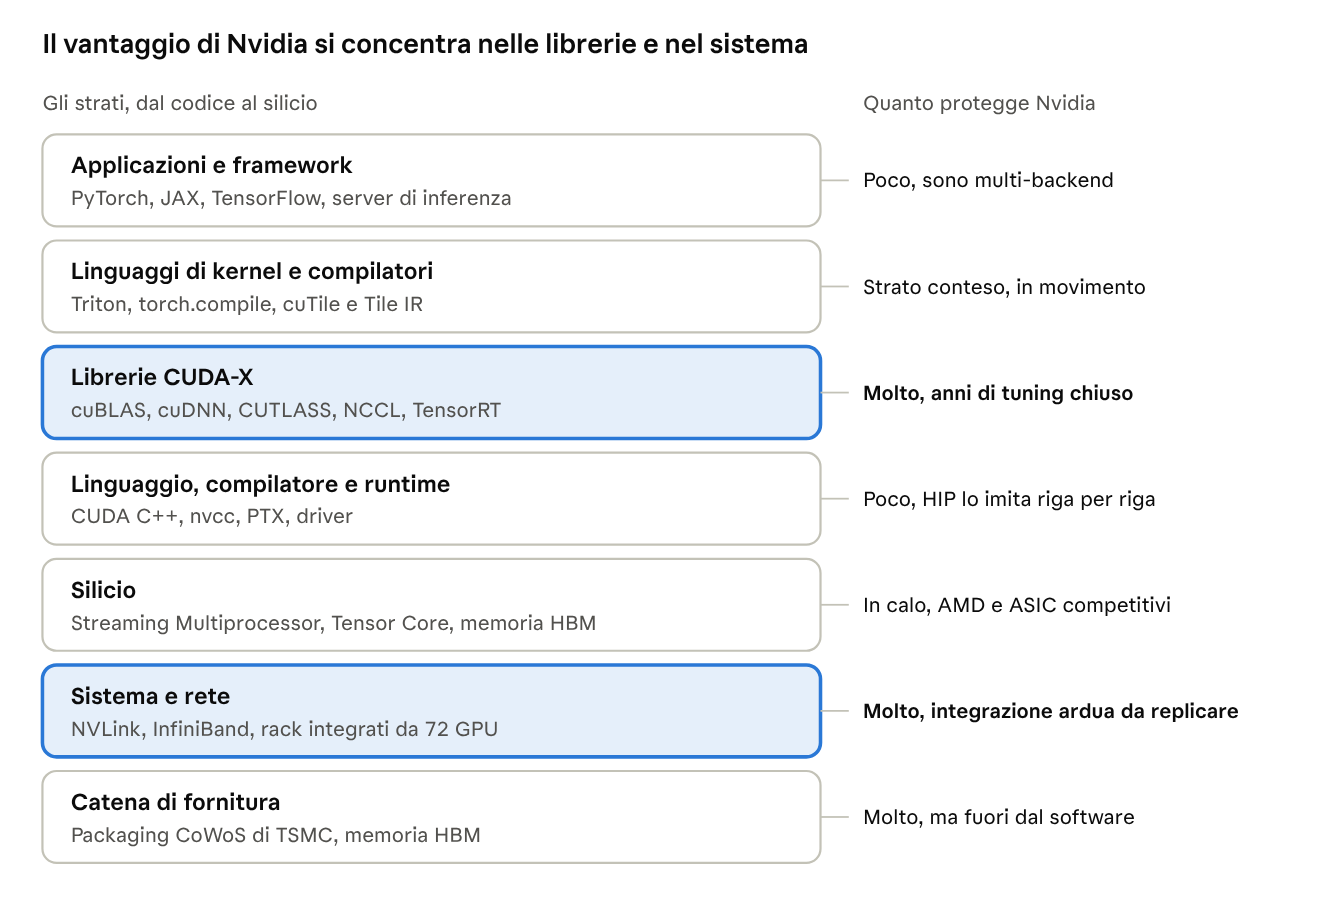
La figura serve da mappa per il resto dell’articolo. Il linguaggio, che è lo strato a cui tutti pensano, è anche quello che protegge meno, mentre il vantaggio si concentra nelle librerie che stanno sopra e nell’integrazione di sistema che sta sotto.
Il modello SIMT e la gerarchia di esecuzione
Il programmatore scrive una funzione, chiamata kernel, che descrive il lavoro di un singolo thread, e poi la lancia su una griglia di migliaia o milioni di thread. I thread sono organizzati in blocchi, e i blocchi formano la griglia; ogni thread conosce le proprie coordinate (threadIdx, blockIdx, blockDim) e le usa per decidere su quale porzione di dati lavorare. Un esempio minimo, l’operazione SAXPY, rende l’idea.
__global__ void saxpy(int n, float a, const float* x, float* y) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n) y[i] = a * x[i] + y[i];
}

// lancio: blocchi da 256 thread, quanti ne servono per coprire n elementi
saxpy<<<(n + 255) / 256, 256>>>(n, 2.0f, d_x, d_y);
In hardware, ogni blocco viene assegnato a uno Streaming Multiprocessor (SM), e all’interno dell’SM i thread vengono eseguiti a gruppi di 32 chiamati warp. Tutti i thread di un warp eseguono la stessa istruzione nello stesso ciclo, su dati diversi, ed è questo che Nvidia chiama SIMT, Single Instruction Multiple Threads. Quando un if manda alcuni thread del warp in un ramo e altri nell’altro, i due rami vengono eseguiti in sequenza con i thread non interessati mascherati, un fenomeno noto come divergenza che dimezza o peggio l’efficienza. Il numero 32 tornerà in gioco quando parleremo di porting verso AMD, dove l’unità equivalente, la wavefront, è storicamente di 64 thread sulle architetture CDNA per data center.
La gerarchia di memoria
La vera difficoltà della programmazione GPU riguarda la memoria più che il calcolo. Ogni thread dispone di registri privati, i thread di un blocco condividono una shared memory on-chip programmabile a bassissima latenza, sopra ci sono le cache L1 e L2, e infine la memoria globale, oggi HBM con banda nell’ordine dei terabyte al secondo ma latenza di centinaia di cicli. Un kernel veloce è quasi sempre un kernel che legge la memoria globale in modo coalescente (thread contigui che leggono indirizzi contigui, così che il controller unisca le richieste in poche transazioni larghe), che riusa i dati caricati in shared memory per più operazioni possibili e che mantiene abbastanza warp attivi da nascondere la latenza mentre altri aspettano i dati. L’occupancy, il rapporto fra warp attivi e warp massimi per SM, dipende dal consumo di registri e di shared memory del kernel, e bilanciarla è un’arte che richiede conoscenza del chip specifico.
Tensor Core e istruzioni specializzate
Dal 2017, con l’architettura Volta, le GPU Nvidia includono i Tensor Core, unità che eseguono in un solo passo una moltiplicazione-accumulo su piccole matrici a precisione ridotta. Da allora quasi tutta la potenza utile per l’AI passa da lì, e l’accesso è cambiato a ogni generazione, dalle API wmma e dalle istruzioni mma.sync di Volta e Ampere, alle wgmma asincrone di Hopper con il Tensor Memory Accelerator (TMA) per le copie di tile, fino alle istruzioni tcgen05 e alla Tensor Memory dedicata di Blackwell. Ogni salto richiede kernel riscritti per ottenere le prestazioni di picco, ed è qui che le librerie di Nvidia, aggiornate in anticipo rispetto al lancio dei chip, fanno la differenza.
La catena di compilazione e il ruolo di PTX
Il compilatore nvcc separa il codice host, compilato dal normale compilatore C++, dal codice device, che viene abbassato su NVVM (un dialetto di LLVM) e tradotto in PTX, un instruction set virtuale documentato pubblicamente. PTX viene poi assemblato da ptxas nel codice macchina reale della singola architettura, chiamato SASS, che invece non è documentato. Gli eseguibili contengono un fatbinary con SASS per le architetture note e PTX come riserva, e il driver può compilare just-in-time quel PTX per GPU uscite dopo il programma. Questo meccanismo, insieme al concetto di compute capability che numera le funzionalità di ogni generazione, ha garantito per vent’anni che codice scritto per una GeForce del 2007 continuasse a girare sui chip successivi, e Nvidia sostiene che oggi giri un milione di volte più veloce su Vera Rubin. La compatibilità all’indietro e in avanti è uno degli asset meno visibili e più preziosi dell’intero ecosistema.
Gli strumenti attorno al linguaggio
Attorno al nucleo ci sono stream ed eventi per sovrapporre calcolo e trasferimenti, CUDA Graphs per ridurre l’overhead di lancio catturando sequenze di kernel, memoria unificata, comunicazione diretta fra GPU, e una suite di strumenti (Nsight Systems, Nsight Compute, compute-sanitizer, cuda-gdb) che permette di vedere contatori hardware, stalli per warp, conflitti di banco in shared memory e utilizzo dei Tensor Core. Chi ha ottimizzato un kernel sa che senza questi strumenti si procede alla cieca, e la loro maturità è stata per anni uno dei divari più netti rispetto alla concorrenza.
Le origini e la scommessa economica (2006-2012)
All’inizio degli anni Duemila alcuni ricercatori avevano capito che le GPU, nate per calcolare il colore di milioni di pixel in parallelo, potevano essere piegate al calcolo scientifico. Lo facevano però travestendo i dati da texture e i calcoli da shader grafici in OpenGL o DirectX, un lavoro acrobatico e fragile che prese il nome di GPGPU. A Stanford, nel gruppo di Pat Hanrahan, Ian Buck sviluppò Brook, un linguaggio a stream che nascondeva parte di questa acrobazia. Nel 2004 Buck entrò in Nvidia, dove lavorò con John Nickolls a quella che sarebbe diventata CUDA.
Il lancio avvenne nel novembre 2006 insieme alla GeForce 8800 GTX, basata sul chip G80, la prima architettura Nvidia con shader unificati, cioè con unità di calcolo generiche invece che specializzate per vertici e pixel. L’SDK pubblico arrivò nel febbraio 2007, seguito dalla prima scheda Tesla dedicata al calcolo. La coincidenza fra hardware e software è essenziale, perché il G80 era stato progettato pensando anche a CUDA, con una memoria condivisa on-chip indirizzabile dal programmatore che le architetture grafiche precedenti non offrivano.
Una piattaforma su ogni scheda venduta
La decisione strategica che distingue Nvidia da tutti i tentativi successivi è stata rendere CUDA disponibile su ogni GPU, comprese le schede da gioco da poche centinaia di dollari, invece di riservarla a una linea professionale costosa. Questo significava aggiungere area di silicio, logica di controllo e lavoro di ingegneria software a prodotti venduti a un pubblico che in larghissima parte non avrebbe mai usato quelle funzioni. Per alcuni anni l’investimento ha pesato sui margini senza ricavi visibili, e la crisi del 2008 ha fatto scendere la capitalizzazione di Nvidia a pochi miliardi di dollari, con analisti e investitori che consideravano il calcolo general purpose una distrazione dal core business grafico.
Il risultato di quella scelta è stato però una base installata enorme e capillare. Ogni studente di dottorato con un PC da gioco aveva in casa una macchina CUDA, e ogni laboratorio universitario poteva comprare una scheda consumer per sperimentare senza passare da un ordine di acquisto per hardware specializzato. Questo abbassamento della soglia d’ingresso è il primo ingrediente del dominio successivo.
Coltivare la comunità prima del mercato
Negli stessi anni Nvidia ha investito in modo sistematico nella formazione. Sono nati i CUDA Centers of Excellence nelle università, a partire dalla University of Illinois, il manuale di David Kirk e Wen-mei Hwu sulla programmazione massicciamente parallela è diventato il testo di riferimento dei corsi, e l’azienda ha distribuito GPU gratuite a gruppi di ricerca, finanziato corsi online e organizzato la GPU Technology Conference dal 2009. Con l’architettura Fermi del 2010, che introduceva memoria ECC, gerarchia di cache, doppia precisione efficiente e supporto C++ più completo, Nvidia entrò seriamente nel calcolo ad alte prestazioni, e nello stesso anno il supercomputer cinese Tianhe-1A raggiunse il primo posto della TOP500 grazie a GPU Tesla.
In quel periodo il calcolo scientifico (dinamica molecolare, fluidodinamica, finanza quantitativa, sismica) era un mercato di nicchia che non giustificava la spesa. Serviva però a costruire ciò che sarebbe servito dopo, cioè migliaia di persone che sapevano programmare GPU, una letteratura scientifica che dava per scontato CUDA e un insieme di librerie numeriche già mature quando arrivò il deep learning.
AlexNet e la nascita dello stack per il deep learning
Nel 2012 Alex Krizhevsky, Ilya Sutskever e Geoffrey Hinton vinsero la competizione ImageNet con una rete convoluzionale addestrata su due GeForce GTX 580 da 3 GB, con un errore top-5 del 15,3% contro il 26,2% del secondo classificato. Il codice, cuda-convnet, era scritto a mano in CUDA da Krizhevsky. Quella vittoria è comunemente indicata come l’inizio dell’era del deep learning, e merita attenzione il fatto che sia avvenuta su schede da gioco, cioè esattamente sull’hardware che la scommessa del 2006 aveva reso programmabile e diffuso.
Nvidia capì rapidamente che cosa stava succedendo e fece la mossa che consolidò il vantaggio. Nel 2014 rilasciò cuDNN, una libreria di primitive ottimizzate per reti neurali (convoluzioni, pooling, normalizzazioni, attivazioni, poi celle ricorrenti e attention), che i framework dell’epoca come Caffe, Theano e Torch adottarono quasi subito. Il significato economico di cuDNN è profondo, perché trasferiva da ogni singolo gruppo di ricerca a Nvidia il costo di scrivere e mantenere i kernel più critici. Un ricercatore che voleva provare una nuova architettura non doveva più diventare esperto di shared memory e coalescenza, bastava chiamare la libreria, e la libreria girava al meglio solo su hardware Nvidia.
Quando nel 2015 Google pubblicò TensorFlow e nel 2016 Meta (allora Facebook) rilasciò PyTorch, entrambi furono costruiti con CUDA e cuDNN come backend primario. Il fatto si è impresso perfino nel linguaggio quotidiano degli sviluppatori, dato che in PyTorch il dispositivo acceleratore si chiama letteralmente "cuda", al punto che anche le GPU AMD, quando usate tramite ROCm, vengono esposte con lo stesso nome per non rompere il codice esistente. Un marchio commerciale è diventato il nome generico della categoria, come accade solo agli standard veri.
Gli anni successivi hanno visto una co-evoluzione stretta fra ricerca e hardware. Nel 2016 Huang consegnò personalmente il primo DGX-1 a OpenAI, nel 2017 Volta introdusse i Tensor Core nello stesso anno in cui usciva l’articolo sul Transformer, e l’addestramento a precisione mista divenne pratica standard proprio perché i Tensor Core lo rendevano conveniente. Ogni innovazione algoritmica veniva prototipata su GPU Nvidia, ottimizzata su GPU Nvidia e pubblicata con codice che presupponeva GPU Nvidia, e ogni nuova generazione di chip veniva disegnata guardando ai carichi di lavoro che quella ricerca produceva. FlashAttention, nel 2022, è l’esempio più chiaro di questo ciclo, un algoritmo il cui guadagno nasce interamente dalla conoscenza della gerarchia di memoria delle GPU Nvidia e che è stato scritto prima per CUDA e solo dopo, con fatica, adattato altrove.
Lo stack CUDA-X, dove abita davvero il valore
Quando si parla di «fossato CUDA» si pensa spesso al linguaggio, cioè alla sintassi dei kernel, ma la sintassi è la parte più facile da imitare e infatti AMD l’ha imitata quasi riga per riga con HIP. Il valore si concentra negli strati sopra e sotto il linguaggio. Alla GTC di marzo 2026, celebrando i vent’anni della piattaforma, Nvidia ha parlato di oltre mille librerie CUDA-X, di una comunità fra i 4 e i 6 milioni di sviluppatori a seconda della fonte aziendale e di un paio di centinaia di migliaia di progetti pubblici che dipendono da CUDA. Huang ha definito le librerie «i gioielli della corona» dell’azienda, ed è una descrizione tecnicamente accurata.
| Libreria | Funzione | Perché conta |
|---|---|---|
| cuBLAS / cuBLASLt | Moltiplicazioni matriciali dense (GEMM) | La GEMM è la quasi totalità del calcolo di un Transformer; ogni punto percentuale di efficienza vale milioni di dollari su un cluster |
| cuDNN | Primitive per reti neurali, attention fusa | Ha spostato su Nvidia il costo dei kernel critici per tutta la ricerca |
| CUTLASS / CuTe | Template C++ open source per costruire GEMM e convoluzioni su misura | È la base su cui sono scritti molti kernel di FlashAttention e degli stack di inferenza |
| NCCL | Comunicazioni collettive fra GPU (all-reduce, all-gather) su NVLink e InfiniBand | Senza collettive efficienti non esiste addestramento distribuito su migliaia di GPU |
| TensorRT / TensorRT-LLM | Compilazione e ottimizzazione dell’inferenza | Quantizzazione, fusione di kernel, batching in produzione |
| CUB / Thrust | Primitive parallele (scan, sort, reduce) | Mattoni di base per chi scrive kernel propri |
| cuFFT, cuSPARSE, cuSOLVER, RAPIDS | Calcolo scientifico, algebra sparsa, data science | Il retaggio HPC che porta utenti fuori dall’AI |
Il lavoro nascosto dentro queste librerie è enorme. Una GEMM ottimale dipende dalla forma delle matrici, dal tipo di dato (FP32, BF16, FP8, FP4 e i formati a blocchi come MXFP), dall’architettura, dalla dimensione delle tile, dal numero di stadi di pipeline e dalla strategia di scheduling, e cuBLAS contiene euristiche e kernel specializzati per migliaia di combinazioni. Questo lavoro viene rifatto a ogni generazione, spesso prima che il chip sia in commercio, perché Nvidia ha accesso al silicio e alla documentazione interna dell’ISA reale (SASS) con mesi di anticipo. Molte di queste librerie sono distribuite solo come binari, e quindi il loro contenuto non può essere semplicemente ricompilato per un altro hardware.
PTX come contratto di lungo periodo
Il secondo pilastro poco visibile è la stabilità. PTX funziona come un contratto fra Nvidia e gli sviluppatori, perché garantisce che il codice scritto oggi venga eseguito anche su GPU future tramite la compilazione JIT del driver. Per un’azienda che deve ammortizzare anni di sviluppo software, sapere che l’investimento sopravviverà al ricambio dell’hardware è un argomento commerciale potentissimo, e spiega perché il costo percepito di restare su CUDA sia così basso rispetto al costo percepito di uscirne. Le piattaforme concorrenti, che per anni hanno cambiato API, supportato poche schede alla volta e interrotto il supporto a hardware recente, hanno trasmesso il messaggio opposto.
Perché è diventato lo standard, in chiave socioeconomica
La storia tecnica spiega perché CUDA era buono, ma non basta a spiegare perché sia diventato quasi impossibile da scalzare. Per questo servono alcuni concetti dell’economia delle piattaforme e dell’innovazione, che nel caso di CUDA operano tutti insieme e si rinforzano a vicenda.
Effetti di rete indiretti e il volano
CUDA è una piattaforma a due versanti, con da una parte chi compra hardware e dall’altra chi scrive software. Più GPU Nvidia esistono, più conviene agli sviluppatori scrivere per CUDA; più software CUDA esiste, più conviene comprare GPU Nvidia. È il meccanismo che Huang presenta da anni come «volano CUDA», articolato in una base installata che attrae sviluppatori, sviluppatori che producono algoritmi e scoperte, scoperte che aprono mercati e mercati che allargano la base installata. In economia si chiama effetto di rete indiretto, ed è lo stesso che ha reso Windows dominante negli anni Novanta, con la differenza che Nvidia controlla anche l’hardware e quindi cattura il valore su entrambi i lati.
Dipendenza dal percorso
Paul David e Brian Arthur hanno descritto come un vantaggio iniziale, anche casuale, possa fissare uno standard per decenni quando i rendimenti sono crescenti. CUDA ha beneficiato di un tempismo quasi perfetto, perché era l’unica piattaforma matura, documentata e disponibile su hardware economico nel momento esatto (2012-2016) in cui il deep learning esplodeva. Le scelte fatte allora da poche decine di gruppi di ricerca si sono propagate a tutto ciò che è venuto dopo, dai framework ai corsi universitari, dalle architetture dei modelli ai formati numerici.
Capitale umano specifico
Un ingegnere che ha passato cinque anni a ottimizzare kernel CUDA possiede competenze solo in parte trasferibili. Sa leggere i report di Nsight, conosce le idiosincrasie di ogni generazione, ricorda quale versione di cuDNN ha introdotto quale regressione. Le aziende assumono persone con queste competenze perché il loro stack è CUDA, e le persone imparano CUDA perché le offerte di lavoro lo chiedono, così il mercato del lavoro diventa esso stesso un meccanismo di lock-in. Lo stesso vale per la conoscenza diffusa, cioè risposte su forum, issue risolte su GitHub, articoli di blog e post-mortem, che costituiscono un patrimonio collettivo enorme e quasi interamente specifico per CUDA.
Costi di passaggio e avversione al rischio
Shapiro e Varian hanno mostrato che il lock-in dipende meno dal costo dell’alternativa che dal costo totale del passaggio, che include migrazione del codice, riqualificazione, rischio di regressioni e perdita di tempo. Nell’AI di frontiera il tempo vale più di quasi qualsiasi altra cosa. Un laboratorio che addestra un modello da centinaia di milioni di dollari non accetta il rischio che un bug nel compilatore di un fornitore alternativo rovini settimane di calcolo, e uno sconto del 20-30% sull’hardware perde significato se comporta un ritardo di un trimestre rispetto ai concorrenti. È la versione contemporanea del vecchio adagio secondo cui nessuno veniva licenziato per aver comprato IBM.
Asset complementari e liquidità
David Teece ha spiegato che chi controlla gli asset complementari a un’innovazione ne cattura il valore. Nel caso di Nvidia gli asset complementari sono tantissimi, a cominciare dalla disponibilità in ogni cloud pubblico, dove una GPU Nvidia è il prodotto standard che chiunque sa usare. Le GPU Nvidia di fascia alta sono diventate quasi una valuta, con un mercato secondario liquido e un valore residuo stimabile, tanto che sono state usate come garanzia per finanziamenti miliardari da operatori come CoreWeave. Un acceleratore alternativo, anche se più economico, ha un valore di rivendita incerto e una domanda più sottile, e questo pesa sulle decisioni di investimento.
Uno standard proprietario che si muove più veloce dei consorzi
CUDA si è imposto come standard di fatto, senza alcun riconoscimento formale. Gli standard aperti concorrenti, come OpenCL, sono stati gestiti da consorzi dove fornitori con interessi divergenti dovevano accordarsi su ogni estensione, mentre Nvidia poteva aggiungere supporto ai Tensor Core, a nuovi formati numerici o a nuove primitive di sincronizzazione nel giorno stesso del lancio di un chip. La velocità di un singolo proprietario ha battuto la neutralità di un comitato. Nvidia ha poi difeso questo vantaggio anche sul piano contrattuale, inserendo nella licenza del toolkit il divieto di usare strati di traduzione per eseguire output CUDA su hardware non Nvidia, una clausola che è diventata oggetto di discussione pubblica nel 2024.
Il fossato di sistema: hardware, rete e catena di fornitura
Negli ultimi cinque anni il vantaggio di Nvidia si è spostato dal singolo chip al sistema completo, e questo spostamento è decisivo per capire quanto il fossato dipenda davvero dal software. I modelli di frontiera si addestrano su decine o centinaia di migliaia di GPU che devono scambiarsi gradienti e attivazioni con latenze minime, e a quella scala la rete conta quanto il calcolo.
Nel 2019 Nvidia ha annunciato l’acquisizione di Mellanox per circa 6,9 miliardi di dollari, portandosi in casa InfiniBand, che era già lo standard delle interconnessioni nei supercomputer. A questo si sono aggiunti NVLink e NVSwitch per collegare le GPU all’interno di un nodo e poi di un intero rack, fino ai sistemi NVL72 della generazione Blackwell, in cui 72 GPU formano un unico dominio NVLink e si comportano, per il software, quasi come un’unica GPU gigante. La rete è diventata un business a sé, con ricavi di 10,98 miliardi di dollari nel solo quarto trimestre dell’esercizio fiscale 2026, in crescita del 263% su base annua.
Il software serve a tenere insieme questo sistema. NCCL conosce la topologia di NVLink e InfiniBand e sceglie gli algoritmi di comunicazione di conseguenza, i framework di parallelismo come Megatron-LM presuppongono quelle primitive, e gli stack di inferenza distribuita come Dynamo orchestrano la separazione fra prefill e decode su più nodi. Chi vuole sostituire Nvidia deve quindi replicare chip, interconnessione, libreria di comunicazione e software di orchestrazione, e farlo con un’affidabilità sufficiente a reggere settimane di addestramento continuo.
La catena di fornitura come barriera
C’è infine una barriera che il software non tocca affatto. La produzione di acceleratori di fascia alta dipende dalla capacità di packaging avanzato CoWoS di TSMC e dalla disponibilità di memoria HBM da SK Hynix, Samsung e Micron, entrambe risorse scarse e allocate con anni di anticipo. Nvidia, grazie ai volumi e ai pagamenti anticipati, si è assicurata una quota molto ampia di questa capacità, e un concorrente con un ottimo chip può comunque trovarsi limitato da quanti ne riesce a far produrre. A questo si aggiunge la rete di accordi finanziari con i clienti stessi, compresi investimenti in OpenAI, in Anthropic e in operatori cloud specializzati, che alcuni analisti guardano con preoccupazione per la circolarità dei flussi ma che di fatto lega i maggiori acquirenti al fornitore.
Vent’anni di tentativi di sfida
La storia dei concorrenti di CUDA è utile perché mostra quali strategie hanno fallito e quali hanno funzionato almeno in parte, e prepara il terreno per capire perché gli agenti AI rappresentano una minaccia di tipo diverso.
OpenCL, lo standard aperto rimasto a metà
OpenCL nacque nel 2008-2009 su iniziativa di Apple e venne affidato al consorzio Khronos, con l’ambizione di offrire un linguaggio unico per CPU, GPU e acceleratori di qualunque fornitore. Garantiva la portabilità del codice ma non delle prestazioni, perché un kernel ottimizzato per un’architettura girava male su un’altra. Nvidia lo supportò in modo tiepido, restando per anni ferma alla versione 1.2, Apple stessa lo deprecò nel 2018 a favore di Metal, e l’ecosistema di librerie non raggiunse mai la profondità di cuBLAS e cuDNN. I principali framework di deep learning non lo adottarono come backend di prima classe.
ROCm e HIP, l’imitazione dichiarata
AMD ha lanciato ROCm intorno al 2016, con HIP come linguaggio volutamente quasi identico a CUDA e con lo strumento hipify per tradurre automaticamente il codice sorgente. A livello sintattico la traduzione è in gran parte meccanica, e per questo AMD poteva presentare la migrazione come semplice. I problemi sono stati altrove, cioè nel supporto limitato alle schede consumer, nelle rotture fra versioni, nella documentazione meno curata, nella copertura incompleta delle librerie equivalenti (rocBLAS, MIOpen, RCCL) e soprattutto nel divario di prestazioni ottenibili senza un lavoro di ottimizzazione specifico. Le analisi indipendenti pubblicate a fine 2024 sui MI300X descrivevano un hardware con numeri teorici superiori all’H100 ma un software che impediva di raggiungerli fuori dalle configurazioni curate da AMD. Da allora il ritmo è cambiato, con ROCm 7 nel 2025, la versione 10.0 nell’agosto 2026 e una cadenza di rilascio di sei settimane annunciata a luglio.
Un esempio concreto mostra dove finisce la traduzione meccanica. La riduzione a livello di warp è uno degli idiomi più comuni nei kernel ottimizzati, e in CUDA si scrive in questo modo.
// CUDA: somma i valori dei 32 thread di un warp
__device__ float warp_sum(float v) {
    for (int off = 16; off > 0; off >>= 1)
        v += __shfl_xor_sync(0xffffffff, v, off);
    return v;
}
Il codice contiene due assunzioni implicite, l’offset iniziale 16 e la maschera a 32 bit, entrambe valide solo per un warp di 32 thread. Sulle GPU Instinct la wavefront ne conta 64, e una conversione sintattica che rinomina le funzioni lasciando intatte le costanti produce un kernel che compila, gira e somma soltanto metà della wavefront, senza segnalare alcun errore. La versione portabile ricava tutto dalla dimensione reale.
// HIP: corretto su AMD (wavefront da 64) e su Nvidia (warp da 32)
__device__ float wave_sum(float v) {
    for (int off = warpSize / 2; off > 0; off >>= 1)
        v += __shfl_xor(v, off);
    return v;
}
Differenze dello stesso tipo riguardano le maschere di voto, che diventano a 64 bit, i banchi della memoria condivisa, l’assembly PTX inline, che non ha traduzione automatica, e le chiamate ai Tensor Core, che su AMD passano da librerie diverse. La documentazione di HIP avverte da sempre che dopo la conversione resta un lavoro di messa a punto specifico per la piattaforma. Quel lavoro richiede di capire l’intenzione del codice, ed è il tipo di compito in cui un modello linguistico supera uno strumento di riscrittura sintattica.
oneAPI, ZLUDA, SCALE e gli strati di compatibilità
Intel ha puntato su oneAPI e sul linguaggio SYCL, uno standard Khronos basato su C++ moderno, con risultati tecnici rispettabili ma un’adozione limitata, anche per le difficoltà dell’azienda sul fronte degli acceleratori. Un’altra strada è stata quella degli strati di compatibilità binaria o sorgente. ZLUDA, sviluppato da Andrzej Janik e finanziato prima da Intel e poi da AMD fino al 2024, permetteva di eseguire binari CUDA non modificati su GPU di altri produttori, mentre SCALE di Spectral Compute compila sorgenti CUDA direttamente per hardware AMD. Questi approcci si scontrano con due limiti, la clausola di licenza di Nvidia sugli strati di traduzione e il fatto che replicare il comportamento esatto di CUDA non basta a ottenere le prestazioni del codice scritto nativamente per l’hardware di destinazione.
Triton, JAX e le TPU, salire di livello invece di imitare
Le strategie che hanno funzionato meglio sono quelle che hanno evitato il confronto diretto, alzando il livello di astrazione sopra CUDA. Triton, il linguaggio presentato da OpenAI nel 2021 e ideato da Philippe Tillet, permette di scrivere kernel in Python ragionando per blocchi di dati invece che per singoli thread, lasciando al compilatore la gestione di shared memory, coalescenza e Tensor Core. Dal 2023 il compilatore di PyTorch 2 genera automaticamente codice Triton, e Triton ha backend anche per AMD, il che significa che una parte crescente dei kernel usati in produzione non è più scritta direttamente in CUDA.
Sul versante di Google, JAX e il compilatore XLA hanno reso le TPU una piattaforma completa e autonoma, su cui vengono addestrati i modelli Gemini e su cui anche Anthropic ha impegnato grandi volumi di calcolo, insieme ai chip Trainium di AWS. Anche iniziative come MLIR e Mojo di Modular vanno nella stessa direzione. La lezione di questi casi è che il fossato si erode quando qualcuno introduce un livello intermedio controllato da altri, perché a quel punto CUDA diventa uno dei backend possibili invece che l’interfaccia su cui ragionano gli sviluppatori.
Il silicio su misura degli hyperscaler
La pressione più consistente sulla quota di Nvidia è arrivata finora dai chip che i grandi operatori cloud progettano per sé, con Broadcom e Marvell come partner di progettazione che insieme coprono circa il 95% di questo mercato. TrendForce stima che nel 2026 i server basati su ASIC raggiungano il 27,8% delle consegne di server AI, con spedizioni in crescita del 44,6% contro il 16,1% delle GPU commerciali. Google è alla settima generazione di TPU, Amazon ha messo in servizio oltre un milione di chip Trainium, Meta e Microsoft sviluppano MTIA e Maia.
Questi chip non hanno mai avuto bisogno di CUDA perché nascono insieme al proprio stack software e servono carichi interni che il proprietario conosce a fondo. Il loro limite, per chi cerca un’alternativa, è che non si comprano e si possono soltanto affittare nel cloud di chi li ha progettati. Erodono quindi i ricavi di Nvidia presso i clienti più grandi senza offrire al resto del mercato un ecosistema verso cui migrare.
La Cina, un ecosistema senza CUDA per necessità
Il secondo fronte è geopolitico. Le restrizioni statunitensi all’esportazione hanno di fatto chiuso a Nvidia il mercato cinese dei chip avanzati, tanto che le guidance del 2026 non includono ricavi data center dalla Cina, e hanno spinto un intero paese a costruire uno stack alternativo. Huawei ha reso open source nel 2025 CANN, l’equivalente di CUDA per i chip Ascend, e nel marzo 2026 ha accompagnato l’Ascend 950PR con una versione pensata per offrire sostituti quasi diretti delle interfacce CUDA. Il 30 settembre DeepSeek e Huawei hanno pubblicato strumenti comuni, fra cui un linguaggio di alto livello per i kernel e una libreria di moltiplicazione matriciale ottimizzata per Ascend.
La strada resta lunga. Secondo un ricercatore citato dal South China Morning Post, portare su Ascend una pipeline di addestramento nata per CUDA aggiunge almeno il 50% di tempo e di costo, e i laboratori cinesi continuano ad addestrare su hardware Nvidia quando riescono a procurarselo. L’episodio mostra però che un ecosistema alternativo nasce quando l’accesso a quello dominante viene negato, e che la forza di CUDA dipende anche dalla possibilità, per i potenziali concorrenti, di continuare a usarlo.
2026, gli agenti AI che portano CUDA su AMD
Nel corso del 2026 la discussione sul fossato ha cambiato natura, perché per la prima volta il costo della migrazione ha cominciato a scendere senza che nessuno dovesse convincere Nvidia o imporre un nuovo standard. Il fattore nuovo sono i modelli capaci di leggere, capire e riscrivere codice di sistema a basso livello, verificando da soli il risultato.
| Data | Evento | Portata reale |
|---|---|---|
| 12 nov 2026 | Jensen Huang si dimette da CEO e dal consiglio di Nvidia; Colette Kress CEO ad interim | Esce di scena chi gestiva di persona clienti, fornitori e governi |
| 10-11 nov 2026 | Roadshow per l’IPO di Anthropic, Mythos avrebbe messo in funzione su AMD MI355X il prompt processing di un modello in circa tre giorni | Dichiarazione aziendale, limitata a un modello e a una fase dell’inferenza; nessun documento tecnico |
| 30 set 2026 | DeepSeek e Huawei pubblicano strumenti open source per i chip Ascend | Uno stack senza CUDA cresce dove CUDA non arriva più |
| 22-23 lug 2026 | AMD e Anthropic annunciano fino a 2 GW di GPU Instinct serie MI450 in rack Helios dal primo semestre 2027, con investimento AMD fino a 5 miliardi; debutta ROCm.ai | Primo laboratorio di frontiera impegnato su AMD a scala di gigawatt |
| 22 gen 2026 | Uno sviluppatore porta con Claude Code un backend CUDA su ROCm in circa 30 minuti | Progetto open source, provato su una sola GPU consumer |
Gennaio, la dimostrazione su Reddit
Il primo segnale è arrivato da uno sviluppatore noto come johnnytshi, che ha usato Claude Code per scrivere un backend ROCm completo per un motore scacchistico basato su reti neurali con attention, con varianti FP32, FP16 e rilevamento automatico, appoggiandosi a MIOpen come equivalente di cuDNN e senza passare da hipify. L’unico ostacolo serio riportato riguardava le differenze di layout dei dati fra le due piattaforme. La notizia ha avuto un’eco enorme, anche se i commentatori più attenti hanno notato subito i limiti dell’esperimento, cioè una base di codice contenuta, prove su una sola architettura AMD consumer e nessuna pretesa di parità con versioni ottimizzate a mano.
Luglio, un fine settimana su un rack MI355X
All’evento Advancing AI di luglio AMD e Anthropic hanno annunciato una collaborazione pluriennale che comprende l’uso di Claude per accelerare lo sviluppo di ROCm e l’adozione di Claude nei team di ingegneria di AMD. In quell’occasione è stato raccontato per la prima volta l’episodio che a novembre sarebbe finito nel roadshow. AMD aveva consegnato ad Anthropic un rack di MI355X, un ingegnere aveva affidato l’adattamento al modello lasciandolo lavorare in autonomia per il fine settimana, e il lunedì il team aveva davanti le curve di prestazione del proprio modello di punta su quell’hardware, in salita costante.
Nello stesso evento AMD ha presentato ROCm.ai, che fornisce agli agenti di coding (Claude, Codex, Cursor, Gemini) skill dedicate, una riga di comando deterministica e scriptabile e una console con telemetria e profilazione, con l’obiettivo dichiarato di trasformare gli agenti in utenti esperti di ROCm. AMD ha spiegato che i propri ingegneri usavano da un anno strumenti di coding assistito per generare kernel, ottimizzare codice e fare debug, con risultati migliori del previsto. La scelta è significativa, perché AMD ha smesso di inseguire Nvidia nella formazione di sviluppatori umani e ha cominciato a rendere la propria piattaforma leggibile per gli agenti.
Novembre, i tre giorni di Mythos
L’affermazione più forte è arrivata nei materiali per gli investitori legati all’IPO di Anthropic. Il cofondatore e Chief Compute Officer Tom Brown ha spiegato che l’azienda addestra e serve Claude su tutte e quattro le principali famiglie di chip (Trainium, TPU, GPU Nvidia e GPU AMD) e le tratta come un unico pool di calcolo intercambiabile. Per l’esordio su AMD il lavoro è stato affidato a Mythos, che secondo Brown ha scritto o portato quasi il 100% dei kernel con «basically no human intervention», in circa tre giorni contro i sei-dodici mesi e le decine di ingegneri dell’approccio tradizionale.
Le cautele stanno nella nota a piè della slide, che circoscrive i tre giorni al prompt processing di un solo modello Anthropic su MI355X, portato a un livello di prestazioni definito utile. Restano fuori la generazione dei token, l’addestramento e ogni confronto numerico con l’hardware Nvidia. Il dato proviene da una presentazione per investitori, cioè da un contesto in cui l’azienda ha tutto l’interesse a mostrare efficienza nell’uso del capitale, e a metà novembre non risulta pubblicato alcun documento tecnico che descriva il porting.
Va ricordato infine l’intreccio degli interessi. Nvidia resta fornitore e investitore di Anthropic, con un impegno fino a 10 miliardi di dollari preso nel novembre 2025 e la partecipazione al collocamento privato descritto nel prospetto S-1/A del 10 novembre, lo stesso a cui partecipa AMD. Il prospetto lega inoltre ad AMD una fornitura di MI450 che nel 2027, se interamente acquistata, supererebbe i 20 miliardi di dollari. Chi racconta la facilità del porting ha quindi un rapporto commerciale rilevante con entrambe le parti in causa.
L’episodio si inserisce comunque in una pratica ormai diffusa. Nvidia stessa pubblica sul proprio blog esempi di traduzione di codice CUDA fra linguaggi tramite agenti, e gli hackathon del 2026 sul calcolo AMD hanno prodotto decine di pipeline multi-agente che classificano i kernel, li traducono in HIP, li compilano su MI300X e confrontano i risultati con l’originale. In meno di un anno la traduzione assistita da modelli è passata da curiosità a normale strumento di lavoro.
Quanto è davvero a rischio CUDA
Il rischio è reale e selettivo. Gli agenti colpiscono con precisione il meccanismo che per vent’anni ha reso costoso abbandonare CUDA, cioè il lavoro umano specializzato necessario per riscrivere e ottimizzare il codice, e lasciano quasi intatti gli strati del fossato che non dipendono dal software. La parte colpita coincide però con i clienti che generano la quota più grande dei ricavi, e per questo l’effetto potenziale supera di molto la portata tecnica della singola dimostrazione.
Una minaccia di tipo nuovo
Tutti i tentativi precedenti chiedevano agli sviluppatori di cambiare abitudini, linguaggio o fornitore di fiducia. Gli agenti lavorano sul codice CUDA esistente e ne ricavano codice nativo per l’altra piattaforma, conoscendo entrambi gli ecosistemi meglio della media degli ingegneri. In termini economici riducono nello stesso momento i costi di passaggio e la specificità del capitale umano, due dei pilastri descritti sopra. Un’azienda che prima doveva assumere una squadra di specialisti ROCm, rari e costosi, può affidare all’agente la prima traduzione e concentrare gli esperti sulla validazione.
Che cosa è stato dimostrato e che cosa manca
Il prompt processing è il caso più favorevole. È dominato da grandi moltiplicazioni matriciali regolari, limitate dalla capacità di calcolo, che si mappano con relativa naturalezza sulle librerie GEMM di AMD. La generazione token per token è invece limitata dalla banda di memoria e dipende da kernel di attention con cache paginata, decodifica speculativa, instradamento dei Mixture of Experts e comunicazioni fra GPU, tutti punti in cui le differenze di architettura pesano di più. La distinzione è così netta che Nvidia stessa la usa nei propri rack, dove ha cominciato a ospitare chip di terzi specializzati nella fase di decode lasciando il prefill alle GPU.
L’addestramento aggiunge i passaggi all’indietro, la stabilità numerica a bassa precisione, le comunicazioni collettive su migliaia di GPU e la tolleranza ai guasti su esecuzioni di settimane. Nessuna di queste aree è stata oggetto di una dimostrazione pubblica paragonabile a quella sul prefill, e la tabella riassume lo stato delle cose strato per strato.
| Strato del fossato | Difficoltà prima degli agenti | Con agenti capaci | Fossato residuo |
|---|---|---|---|
| Sintassi del linguaggio | Bassa, bastava hipify | Trascurabile | Nessuno |
| Kernel di inferenza, prefill | Alta, mesi di lavoro | Giorni, secondo Anthropic | Basso per chi ha modello e hardware |
| Kernel di inferenza, decode e MoE | Molto alta | In calo, non dimostrato pubblicamente | Medio |
| Addestramento distribuito su larga scala | Molto alta | Da dimostrare | Alto |
| Librerie e tuning per nuove generazioni | Molto alta, con vantaggio temporale di Nvidia | In calo anche per i concorrenti | Medio |
| Interconnessione (NVLink, InfiniBand, NCCL) | Hardware e software insieme | Il software si traduce, l’hardware resta | Alto |
| Catena di fornitura (CoWoS, HBM) | Fuori dal software | Invariata | Alto |
| Coda lunga di aziende e ricerca | Dipende dai framework | Aiuta, ma servono competenze per validare | Medio-alto |
L’inferenza sposta il baricentro
Il peso dell’inferenza sul calcolo totale cresce a ogni trimestre, e l’inferenza riunisce tre caratteristiche sfavorevoli a Nvidia. È il carico più facile da portare, perché per ciascun modello i kernel sono pochi e stabili. È quello su cui il silicio alternativo dichiara i vantaggi di costo maggiori, fino al 65% del costo totale di proprietà secondo le stime più favorevoli riportate dalla stampa specializzata. Ed è quello che un laboratorio controlla per intero, dato che serve i propri modelli con il proprio stack. La somma di questi fattori spiega perché la prima breccia documentata riguardi proprio l’inferenza di un laboratorio di frontiera, e suggerisce che le successive arriveranno dalla stessa direzione.
La verifica come condizione
Un agente che traduce kernel è utile solo dentro un ciclo chiuso, in cui può compilare, eseguire, confrontare i risultati con un riferimento numerico e misurare le prestazioni con un profiler. Per questo ROCm.ai investe su strumenti scriptabili e telemetria esposta agli agenti, e per questo i risultati migliori arrivano da organizzazioni che possiedono un’implementazione di riferimento funzionante, accesso diretto all’hardware e batterie di test estese. I laboratori di frontiera hanno tutte e tre le cose, mentre una media azienda manifatturiera o un gruppo universitario ne hanno raramente più di una. L’erosione si concentra quindi in alto, dove si trovano gli acquirenti da miliardi di dollari, e procede molto più lentamente nella coda lunga.
Le contromosse di Nvidia
Nvidia ha visto arrivare la transizione e risponde su due piani. Il primo è il software. Con CUDA 13.1, nel dicembre 2025, ha introdotto CUDA Tile, un modello di programmazione a tile con una propria rappresentazione intermedia (Tile IR) e il linguaggio cuTile Python, esteso al C++ con CUDA 13.3 insieme a CUDA Python 1.0 e all’autotuning CompileIQ, e ha scritto un backend Tile IR anche per Triton. L’obiettivo è che il livello alto su cui ragionano sviluppatori e agenti, finora conteso da Triton e dai compilatori dei framework, resti dentro l’ecosistema Nvidia e conduca alle ottimizzazioni proprietarie del suo compilatore.
Il secondo piano è il sistema. Con NVLink Fusion, presentato nel 2025, Nvidia concede la propria interconnessione a chi progetta silicio su misura, a condizione che ogni piattaforma contenga almeno un suo prodotto, e nel 2026 ha investito 2 miliardi di dollari in Marvell, che progetta i chip di AWS e di Microsoft. A settembre la startup d-Matrix ha annunciato l’integrazione del proprio acceleratore nei rack Nvidia secondo lo schema descritto sopra, con il prefill sulle GPU e il decode sul chip specializzato. La logica è quella del casello autostradale. Se una parte del calcolo è destinata a migrare su silicio altrui, a Nvidia conviene che lo faccia dentro un rack, una rete e un software di gestione che restano suoi.
Va aggiunto che gli agenti funzionano in entrambe le direzioni. Riducono il costo di portare un modello da Nvidia ad AMD, e riducono allo stesso modo il costo per Nvidia di produrre librerie ottimizzate per ogni nuova architettura e il costo per un cliente di tornare indietro se l’alternativa delude. In un mercato in cui il software si traduce facilmente vince chi offre il miglior rapporto fra prestazioni, costo totale e disponibilità in quel trimestre, una competizione in cui Nvidia parte forte ma con molta meno rendita di posizione.
Margini e potere negoziale
L’effetto più plausibile nel breve periodo riguarda i prezzi. Nell’esercizio 2026 il margine lordo di Nvidia è stato del 71,1%, in discesa dal 75,0% dell’anno precedente per ragioni che l’azienda attribuisce alla transizione verso i sistemi Blackwell e a oneri di magazzino. Margini di questo livello reggono finché i grandi clienti non hanno un’alternativa credibile per i carichi critici, e la clientela è molto concentrata, visto che nello stesso esercizio due clienti diretti hanno pesato per il 22% e per il 14% dei ricavi totali.
Un laboratorio che può dimostrare di spostare l’inferenza su AMD, TPU o Trainium in giorni invece che in mesi siede al tavolo con una minaccia credibile, anche se poi continua a comprare Nvidia. La dichiarazione di Anthropic va letta anche in questa chiave, come un segnale rivolto ai mercati e ai fornitori nel momento in cui l’azienda si prepara alla quotazione.
Un contesto che riduce il margine di errore
L’erosione tecnica arriva in un momento delicato. Huang si è dimesso il 12 novembre, dopo aver ammesso una relazione con una donna che l’intelligence statunitense ritiene una spia cinese e mentre il consiglio conduceva un’indagine indipendente, e con lui esce di scena la persona che per 33 anni ha gestito direttamente i rapporti con clienti, fornitori e governi. Le restrizioni sulla Cina hanno portato a guidance prive di ricavi data center cinesi, e a inizio novembre circolavano stime secondo cui gli sviluppatori cinesi avrebbero ricevuto circa l’1% dei chip avanzati ordinati. Il 5 novembre il titolo ha perso il 9,26% in una giornata di vendite diffuse sui semiconduttori.
Nessuno di questi fattori riguarda CUDA in sé, ma tutti riducono il margine con cui Nvidia può assorbire un indebolimento del proprio vantaggio software. La trimestrale del 17 novembre, la prima firmata da una CEO ad interim, darà indicazioni sui numeri e probabilmente poche sulla dinamica di lungo periodo.
Tre scenari e i segnali da osservare
Le valutazioni che seguono sono mie e vanno prese come ipotesi di lavoro, ordinate dalla più alla meno probabile su un orizzonte di due-tre anni.
| Scenario | Che cosa accade | Segnali da osservare |
|---|---|---|
| Erosione dei margini | La quota resta dominante, l’inferenza dei grandi laboratori diventa multi-piattaforma e i clienti maggiori ottengono condizioni migliori | Margine lordo stabilmente sotto il 70%, annunci di inferenza in produzione su più famiglie di chip |
| Il fossato si sposta sul sistema | CUDA diventa uno dei backend possibili e Nvidia difende il valore con rack, rete e capacità produttiva | Adozione di NVLink Fusion, crescita dei ricavi di rete, Tile IR adottato dai framework |
| Commoditizzazione | L’addestramento di frontiera viene documentato su hardware non Nvidia con prestazioni comparabili | Un documento tecnico verificabile, la consegna effettiva dei 2 GW di Helios nel 2027, AMD oltre il 10-15% dei ricavi di settore |
I primi due scenari sono compatibili fra loro e in parte già in corso. Il terzo richiede che gli agenti gestiscano l’addestramento distribuito e l’ottimizzazione delle nuove generazioni di chip con la rapidità mostrata sul prefill, e a oggi non esiste alcuna prova pubblica che ci riescano.
Conclusioni
Nvidia è diventata ciò che è perché nel 2006 ha deciso di rendere programmabile ogni GPU che vendeva, ha sostenuto quel costo per anni senza ritorni visibili, ha coltivato una comunità accademica prima che esistesse un mercato e si è trovata con l’unica piattaforma pronta quando il deep learning è esploso. Da lì in poi il vantaggio si è alimentato da solo attraverso effetti di rete, dipendenza dal percorso, capitale umano specializzato, librerie che spostavano su Nvidia il costo dell’ottimizzazione e una compatibilità di lungo periodo che rendeva sicuro ogni investimento software. Negli ultimi anni a tutto questo si sono sommati il controllo della rete e un accesso privilegiato alla capacità produttiva.
Gli agenti di coding mettono in discussione la parte di questo edificio che si reggeva sulla scarsità di lavoro esperto. È la parte che più di ogni altra ha impedito ad AMD di trasformare un buon hardware in quote di mercato, e la sua erosione è già visibile nei laboratori che dispongono di modelli, hardware e test propri. Le parti fisiche del fossato restano solide, il silicio su misura e la Cina premono da altre direzioni, e Nvidia lavora per riportare dentro il proprio perimetro sia il livello di astrazione su cui ragioneranno sviluppatori e agenti sia i rack in cui gireranno i chip dei concorrenti.
CUDA sta dunque perdendo la funzione di barriera prima di perdere la posizione di standard, e la differenza fra le due cose si misurerà nei margini più che nelle quote. Il segnale da seguire è la comparsa di un porting documentato e verificabile che comprenda l’addestramento distribuito o l’inferenza completa in produzione, perché da quel momento la concorrenza sugli acceleratori si giocherà su hardware, rete e capacità produttiva, come in qualunque altro settore dei semiconduttori.
Fonti
Anthropic, AMD e il porting assistito
- The Decoder – Anthropic says AI is eroding Nvidia’s CUDA lead (11 nov 2026)
- Simon Willison – Anthropic IPO roadshow (11 nov 2026)
- FourWeekMBA – Anthropic’s AMD bring-up took 3 days, la nota della slide e il prospetto S-1/A
- MadRobot – Mythos e il porting su MI355X (11 nov 2026)
- ExplainX – Claude Mythos AMD MI355X, claimed vs verified
- Longbridge – Il fine settimana sul rack MI355X (luglio 2026)
- HPCwire – Can AMD Lower CUDA’s Moat with ROCm.AI? (29 lug 2026)
- Techstrong.ai – Claude Code Ports NVIDIA CUDA to AMD ROCm in 30 Minutes (26 gen 2026)
- 36Kr – Dettagli tecnici del porting di gennaio
Nvidia, numeri e contesto
- SEC – Nvidia, Form 8-K, NVIDIA Announces CEO Transition (12 nov 2026)
- Fortune – Nvidia’s Jensen Huang resigns
- NBC News – Nvidia CEO Jensen Huang resigns
- edgar.tools – Nvidia, ricavi per mercato finale e concentrazione dei clienti (10-K FY2026)
- TickerGate – Nvidia, ricavi per segmento FY2021-FY2025
- The Energy Mag – Risultati FY2026, margine lordo e Cina
- Trefis – NVDA, capitalizzazione e andamento a novembre 2026
- Computer Weekly – CUDA at 20
- Nvidia – GTC 2026 San Jose Highlights
- Nvidia Developer Forums – 20 Years of CUDA
- Tom’s Hardware – Nvidia’s CUDA Tile examined
- Nvidia Developer Blog – Tile IR backend per Triton
- Nvidia Developer Blog – CUDA 13.3, CUDA Python 1.0, traduzione con agenti
- Nvidia – Marvell e NVLink Fusion
- Tom’s Hardware – Nvidia investe 2 miliardi in Marvell
- FourWeekMBA – Nvidia, d-Matrix e l’inferenza divisa fra prefill e decode
Concorrenti e mercato
- Tom’s Hardware – The custom AI ASIC state of play (maggio 2026)
- MarketsandMarkets – Custom AI ASIC Market
- Command Linux – AI GPU Market Share 2026, stime sulle quote
- Tech Insider – DeepSeek e Huawei, strumenti per Ascend (30 set 2026)
- Wccftech – Ascend 950PR e CANN Next
- AI Weekly – Chinese AI labs still train on Nvidia
- AMD – HIP FAQ
- arXiv – Preparing Ginkgo for AMD GPUs, porting da CUDA a HIP
- Wikipedia – ROCm
I riferimenti storici (Brook, G80, AlexNet, cuDNN, OpenCL, Mellanox, Triton) e i concetti di economia delle piattaforme provengono dalla letteratura nota e non da queste pagine.


